 亦晗
出品 | 网易智能
作者 | 小扣
编辑 | 王凤枝
问同一道题,仅仅多打几个符号,原本答对的DeepSeek却答错了。
这个反常现象,出现在字节跳动Seed团队等研究者9月底公开的一篇预印本论文中。他们用DeepSeek自己公开的代码,给DeepSeek-V4-Flash基础模型出了一道数字填空题。测试时,研究者不改代码,只增减前面注释里的等号,模型却一会儿填对,一会儿填错。
这些等号只是装饰,不影响代码运行,却会改变后面内容的位置。研究者随后测试了从长文本中查找答案:答案明明写在材料里,只是往前或往后挪了几个位置,模型找到它的准确率就可能明显下降。
在开发者社区LINUX DO,网友refalogy看完论文后问:“这会是ds时神时鬼的原因吗?”
没有换题,成绩却差了一截
研究者发现,每多加两个等号,模型就会换一次答案:原来答对的变成答错,再加两个,又答对了。
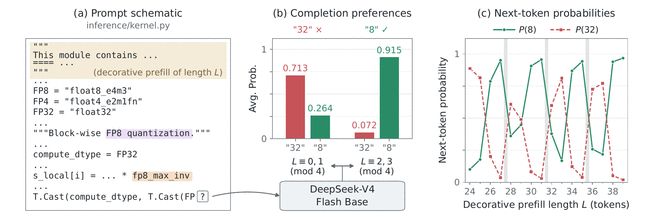
图1|正确的填空数字是“8”。右图绿线表示模型预测“8”的概率,红线表示预测“32”的概率;注释长度变化时,两者交替占优。
研究者又设计了一项长文本查找测试:在128K token的材料里放入1.6万组对应记录,再让模型找出其中某一项的值。材料没有超过模型的上下文上限,答案也已写在其中。
研究者保持材料总长、提问位置和记录的对应关系不变,只调整填充文字的长度,让目标记录挪动几个位置。各组目标记录在全文中的位置分布也做了控制,以免把材料开头、中间或结尾的差异混进来。
在这项长文本查找测试中,DeepSeek-V4-Flash基础版表现最好和最差的位置组,准确率相差40.2个百分点。
社区讨论中,网友DavisZhou注意到了V4.1的改善。从论文数据看,经过后训练的V4-Flash-0731,差距缩小到19.1个百分点;受测的V4.1-Flash-0910进一步缩小到约6.1个百分点。
新版本改善了表现,但这种周期性差异还没有完全消失。
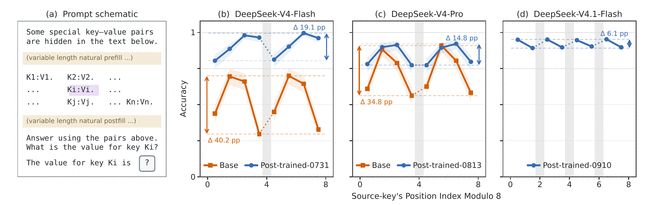
图2|曲线越平,表示不同位置组之间的成绩越接近。图中的40.2、19.1和6.1,均为对应模型最好与最差位置组的准确率差距,单位是百分点。
为什么几个等号也能影响答案
模型会把一部分中间计算结果保存在KV缓存里,供后续生成内容时使用,避免重复计算。材料越长,缓存占用的显存越多,读取开销也越大。
DeepSeek采用的一种办法,是把连续一段token对应的缓存压成更少的条目,减少存储和计算开销。
问题在于,压缩按照固定步长推进。前面多几个等号,后面的代码就整体往后挪了几个位置。
代码含义没变,但它落在压缩窗口的哪个位置、和哪些内容一起被压缩,可能已经变了。
研究者在部分受测模型中发现,压缩机制还会形成固定的位置偏好:某些位置的信息更容易被保留下来、被后续计算用上。即使两条相关信息没有被分到窗口两边,查找表现也可能不同。
平均分不错,也可能藏着弱点
两代DeepSeek在训练和架构上都有变化。为了单独检验压缩的影响,团队以Qwen3-0.6B的架构为基础,从头训练了一批小模型,主要改变KV缓存的压缩方式,再和不采用这种压缩的模型对照。
采用分块压缩的受测模型,都出现了与压缩步长对应的周期性波动;全注意力对照模型没有出现类似规律。
在这批自训小模型的一组对照中,采用压缩的模型与全注意力模型,平均查找准确率分别为59.4%和61.1%,看起来相差不大。
但分别看两者表现最差的位置组,前者只有9.9%,后者仍有58.4%。
不过,论文还没有给出一套通用修复办法,也没有统计这种现象在真实文档、编程项目中会造成多少错误。
靠多加几个空格来“救活”模型,同样不是经过验证的解决方案:这次挪到了容易找的位置,下次未必还有效。
技术作者Julien Simon在10月4日的一篇文章中,梳理了不同注意力机制节省的成本和付出的代价。他建议,除了平均分,还要分别检查不同位置的检索成绩。
要考的不是它能不能偶尔找到答案,而是前面多了几个无关的字,原本会答的题还能不能答对。
